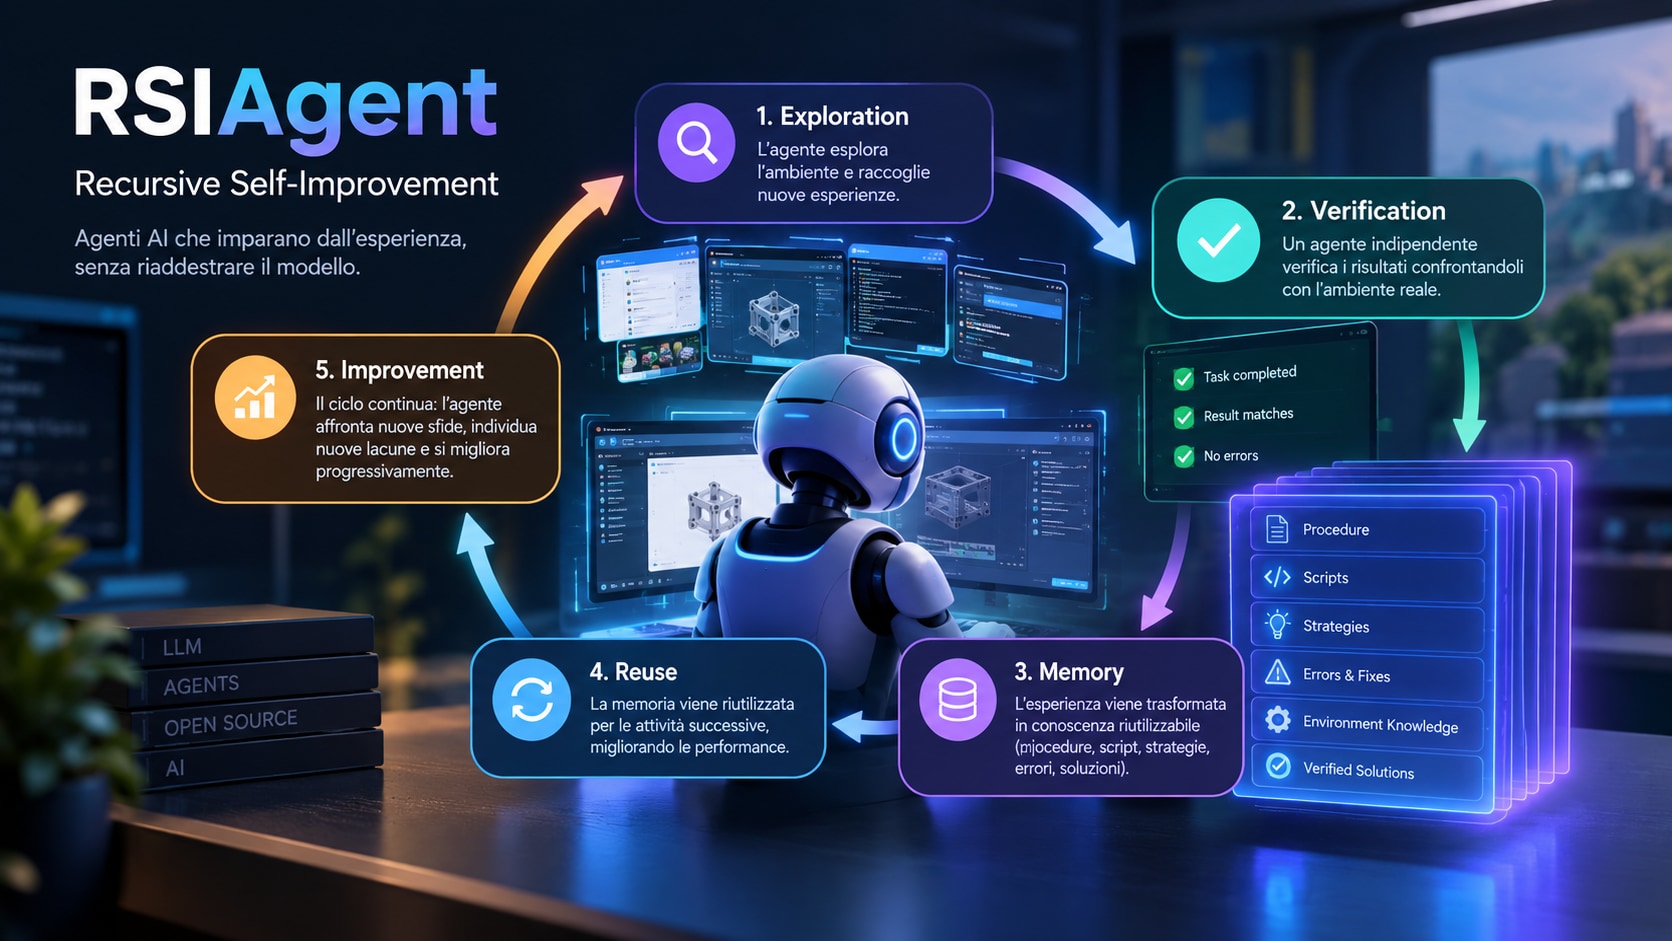
Nel campo degli AI Agent sta emergendo una direzione particolarmente interessante: non rendere necessariamente più intelligente il modello attraverso un nuovo training, ma permettergli di imparare dall’esperienza accumulata durante l’interazione con un ambiente.
È questa l’idea alla base di RSIAgent, un progetto open source di Aether AI che propone un framework multi-agente per la recursive self-improvement in ambienti digitali nuovi e sconosciuti.
Il codice è disponibile su GitHub con licenza Apache 2.0.
L’idea: non ripartire ogni volta da zero
Uno dei limiti degli attuali agenti basati su LLM è che una nuova attività può spesso significare una nuova fase di esplorazione.
L’agente prova un’azione, commette un errore, trova una soluzione e conclude il task. Ma alla successiva attività simile potrebbe essere costretto a riscoprire nuovamente la stessa procedura.
RSIAgent introduce un concetto diverso:
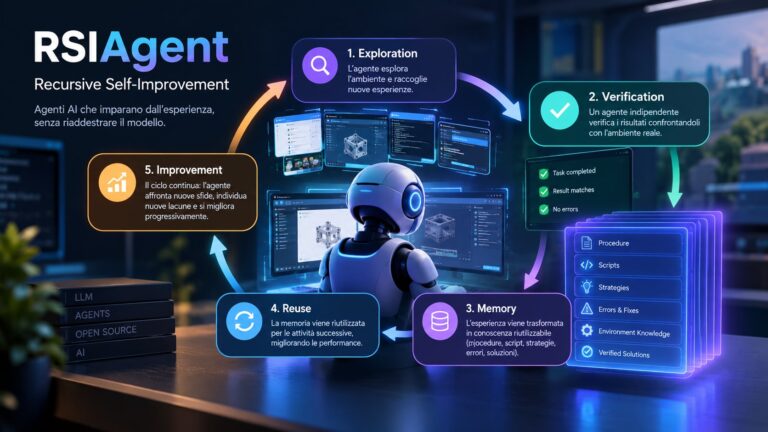
l’esperienza acquisita durante l’esplorazione diventa memoria riutilizzabile per le attività successive.
Il punto interessante è che questo avviene senza modificare i pesi del modello.
Il modello rimane quindi sostanzialmente lo stesso; ciò che evolve è la conoscenza operativa accumulata dall’agente attraverso l’interazione con l’ambiente.
Tre agenti, tre responsabilità
L’architettura di RSIAgent si basa su tre componenti principali:
🧭 Curriculum Agent
Decide cosa esplorare successivamente.
Utilizza i risultati delle attività precedenti e la memoria accumulata per individuare nuove esperienze potenzialmente utili, scegliendo progressivamente attività più mirate.
🤖 Actor Agent
È l’agente che interagisce realmente con l’ambiente.
Può utilizzare programmi Python o Bash e osservazioni visuali per eseguire le attività richieste.
Dopo l’esecuzione, l’esperienza viene analizzata e trasformata in conoscenza riutilizzabile.
🔍 Verifier Agent
Ha il compito di verificare indipendentemente il risultato.
Questo passaggio è particolarmente importante: l’agente non deve semplicemente “credere” di aver completato correttamente un’attività.
Il risultato deve essere confrontato con ciò che è realmente accaduto nell’ambiente.
La separazione tra Actor e Verifier introduce quindi un meccanismo di feedback basato sull’esecuzione reale, anziché esclusivamente sull’autovalutazione del modello.
Broad → Deep: prima esplorare, poi specializzarsi
Uno degli aspetti più interessanti di RSIAgent è la strategia definita Broad-then-Deep.
Il processo viene articolato in più fasi.
1. Broad Recursive Self-Exploration
L’agente affronta una serie di attività diverse per costruire una prima conoscenza dell’ambiente.
L’obiettivo non è necessariamente ottenere subito la massima performance, ma raccogliere una quantità sufficientemente ampia di esperienze.
2. Deep Recursive Self-Exploration
Una volta individuate le aree problematiche, il sistema concentra l’esplorazione sui casi più difficili, sui vincoli nascosti e sulle situazioni in cui le strategie precedenti si sono dimostrate fragili.
La memoria viene quindi progressivamente raffinata.
3. Test-time Memory Reuse
Quando arriva una nuova attività, l’agente può utilizzare la memoria precedentemente costruita.
In questa fase la memoria viene congelata e non viene più utilizzata per continuare il processo di apprendimento.
Il risultato è un modello interessante:
esperienza → verifica → memoria → nuova esperienza
piuttosto che:
task → risposta → fine
La memoria diventa una forma di “apprendimento”
Qui probabilmente si trova l’aspetto più interessante del progetto.
La memoria non contiene solamente una cronologia delle conversazioni.
Può contenere:
- procedure;
- script;
- strategie operative;
- errori precedentemente commessi;
- condizioni di fallimento;
- conoscenza specifica dell’ambiente;
- soluzioni verificate.
In altre parole, l’agente costruisce progressivamente una sorta di manuale operativo dinamico dell’ambiente.
Questo approccio potrebbe essere particolarmente interessante per software complessi nei quali esistono procedure ricorrenti, interfacce non standardizzate e numerosi casi limite.
Non è “training” nel senso tradizionale
È importante distinguere RSIAgent dal fine-tuning classico.
Nel fine-tuning:
dataset → training → aggiornamento dei pesi → nuovo modello
Con RSIAgent:
interazione → esperienza → verifica → memoria → riutilizzo
I parametri del modello rimangono invariati durante l’esplorazione e durante l’esecuzione dei task successivi.
Questo rende il concetto particolarmente interessante anche dal punto di vista dei costi e della velocità di sperimentazione: l’agente può accumulare esperienza senza dover necessariamente avviare ogni volta un nuovo processo di training.
Naturalmente, questo non significa che la memoria sia automaticamente corretta. Gli stessi autori evidenziano tre possibili problemi: l’esplorazione può non individuare la debolezza rilevante, il verificatore può accettare un risultato incompleto e la memoria può conservare una regola errata.
I benchmark
Il progetto è stato integrato con OSWorld-V2 e Agents’ Last Exam (ALE).
Nel materiale pubblicato dagli autori vengono riportati, per il protocollo considerato, valori medi di partial-credit che mostrano un miglioramento tra la configurazione senza RSI e quella con RSI:
| Benchmark | Senza RSI | Con RSIAgent |
|---|---|---|
| OSWorld 2.0 | 71,97% | 78,98% |
| Agents’ Last Exam | 83,75% | 84,82% |
È però importante leggere questi numeri nel loro contesto: gli stessi autori specificano che la colonna RSI utilizza un insieme di esecuzioni, retry e checkpoint non equivalenti a una media ottenuta da ripetizioni perfettamente abbinate. Non si tratta quindi di un confronto sperimentale da interpretare come un semplice “prima vs dopo”.
Un progetto interessante anche per chi lavora con AI locale
RSIAgent è particolarmente interessante osservato dalla prospettiva dell’AI agentica.
La domanda non è più soltanto:
“Quale modello è più intelligente?”
ma diventa:
“Quanto può diventare efficace un agente quando gli permettiamo di costruire e riutilizzare esperienza?”
Questo cambia anche il modo di progettare sistemi AI.
Un agente potrebbe partire da un modello generalista e costruire progressivamente una memoria specializzata per:
- un software aziendale;
- un CRM;
- un gestionale;
- un ambiente di sviluppo;
- una piattaforma di e-commerce;
- un sistema di telefonia;
- un’infrastruttura IT;
- procedure operative interne.
In questi scenari la conoscenza più importante potrebbe non essere quella contenuta nel modello di base, ma quella specifica dell’ambiente nel quale l’agente deve operare.
Perché è un progetto da tenere d’occhio
RSIAgent si inserisce in una tendenza più ampia: il passaggio dagli LLM come semplici generatori di testo agli agenti capaci di osservare, agire, verificare e accumulare esperienza.
Il vero elemento di interesse non è quindi soltanto il singolo benchmark.
È l’architettura.
Un sistema nel quale:
l’agente esplora → verifica → memorizza → utilizza ciò che ha imparato → individua nuove lacune → esplora nuovamente
assomiglia molto di più a un processo di apprendimento continuo rispetto al tradizionale paradigma “prompt → risposta”.
E soprattutto introduce una possibilità interessante: far evolvere il comportamento di un agente senza dover necessariamente evolvere il modello sottostante.
Il progetto è open source, scritto in Python e utilizza, tra gli altri componenti, Docker e ambienti virtualizzati per le integrazioni con i benchmark. Per l’installazione viene indicato Python 3.12, uv, un host Linux con Docker e accesso a /dev/kvm.
Per chi sta lavorando su AI agent, computer-use, memoria persistente e sistemi di AI autonoma, RSIAgent rappresenta quindi un progetto da seguire con attenzione.
Repository: github.com/AetherLabsAI/RSIAgent
Research project: RSIAgent – Aether AI Research