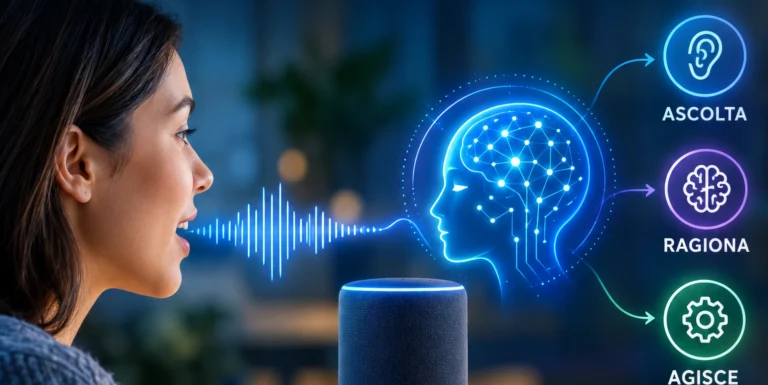
Gli assistenti vocali stanno entrando in una nuova fase. Non si limitano più a riconoscere una domanda, trasformarla in testo e restituire una risposta sintetica: i modelli più recenti possono mantenere una conversazione continua, interpretare ciò che vedono, usare strumenti esterni e svolgere attività mentre dialogano con l’utente.
La differenza è importante. L’obiettivo non è più soltanto parlare con un chatbot, ma interagire con un assistente digitale capace di comprendere il contesto e portare a termine un’azione.
Dal comando vocale alla conversazione
I sistemi vocali tradizionali funzionano generalmente attraverso una sequenza di passaggi:
- registrano la voce;
- convertono l’audio in testo;
- inviano il testo a un modello linguistico;
- trasformano la risposta in audio;
- riproducono la risposta.
Ogni passaggio può introdurre ritardi e perdita di informazioni. Pause, esitazioni, interruzioni e rumori di fondo diventano difficili da interpretare.
I modelli vocali di nuova generazione cercano di rendere questo processo più diretto e naturale. L’utente può interrompere l’assistente, correggersi o aggiungere informazioni senza dover attendere la fine della risposta.
Gemini 3.8 Live
Google ha presentato Gemini 3.8 Live e Gemini 3.8 Live Extended Thinking, due modelli progettati per conversazioni vocali in tempo reale. La prima versione punta soprattutto a un dialogo rapido e naturale, mentre la seconda è pensata per attività che richiedono maggiore pianificazione e ragionamento multi-step.
Gemini 3.8 Live può combinare voce, immagini e strumenti esterni. Durante una conversazione, l’utente può mostrare un oggetto, una schermata o un documento e chiedere all’assistente di analizzarlo.
Un possibile esempio è questo:
“Guarda l’errore che compare sullo schermo e dimmi come risolverlo.”
L’assistente può osservare l’immagine, interpretare il messaggio e, se collegato agli strumenti appropriati, verificare documentazione o sistemi aziendali senza interrompere necessariamente il dialogo.
La variante Extended Thinking è invece più adatta a richieste complesse. Può elaborare un piano, chiamare diversi strumenti e comunicare all’utente ciò che sta facendo mentre procede. Google cita casi d’uso come prenotazioni, gestione di attività e sviluppo di applicazioni a partire da uno schizzo.
GPT-Live-1 di OpenAI
Anche OpenAI si sta muovendo nella stessa direzione con GPT-Live-1, un modello API dedicato alle esperienze vocali full-duplex. In questo tipo di interazione l’assistente può ascoltare e parlare contemporaneamente, gestendo in modo più naturale le interruzioni e i cambi di turno.
Per gli sviluppatori, uno degli aspetti più interessanti è il controllo sul comportamento dell’agente. È possibile definire tono, ritmo, stile comunicativo e modalità di risposta, mantenendo una conversazione più coerente con il brand o con il servizio offerto.
GPT-Live-1 può inoltre occuparsi dell’interazione vocale mentre un modello backend più potente gestisce il ragionamento complesso. Questa separazione permette di ottimizzare il sistema: un modello rapido mantiene il dialogo, mentre un altro analizza documenti, pianifica attività o utilizza strumenti aziendali.
Assistenti che usano strumenti
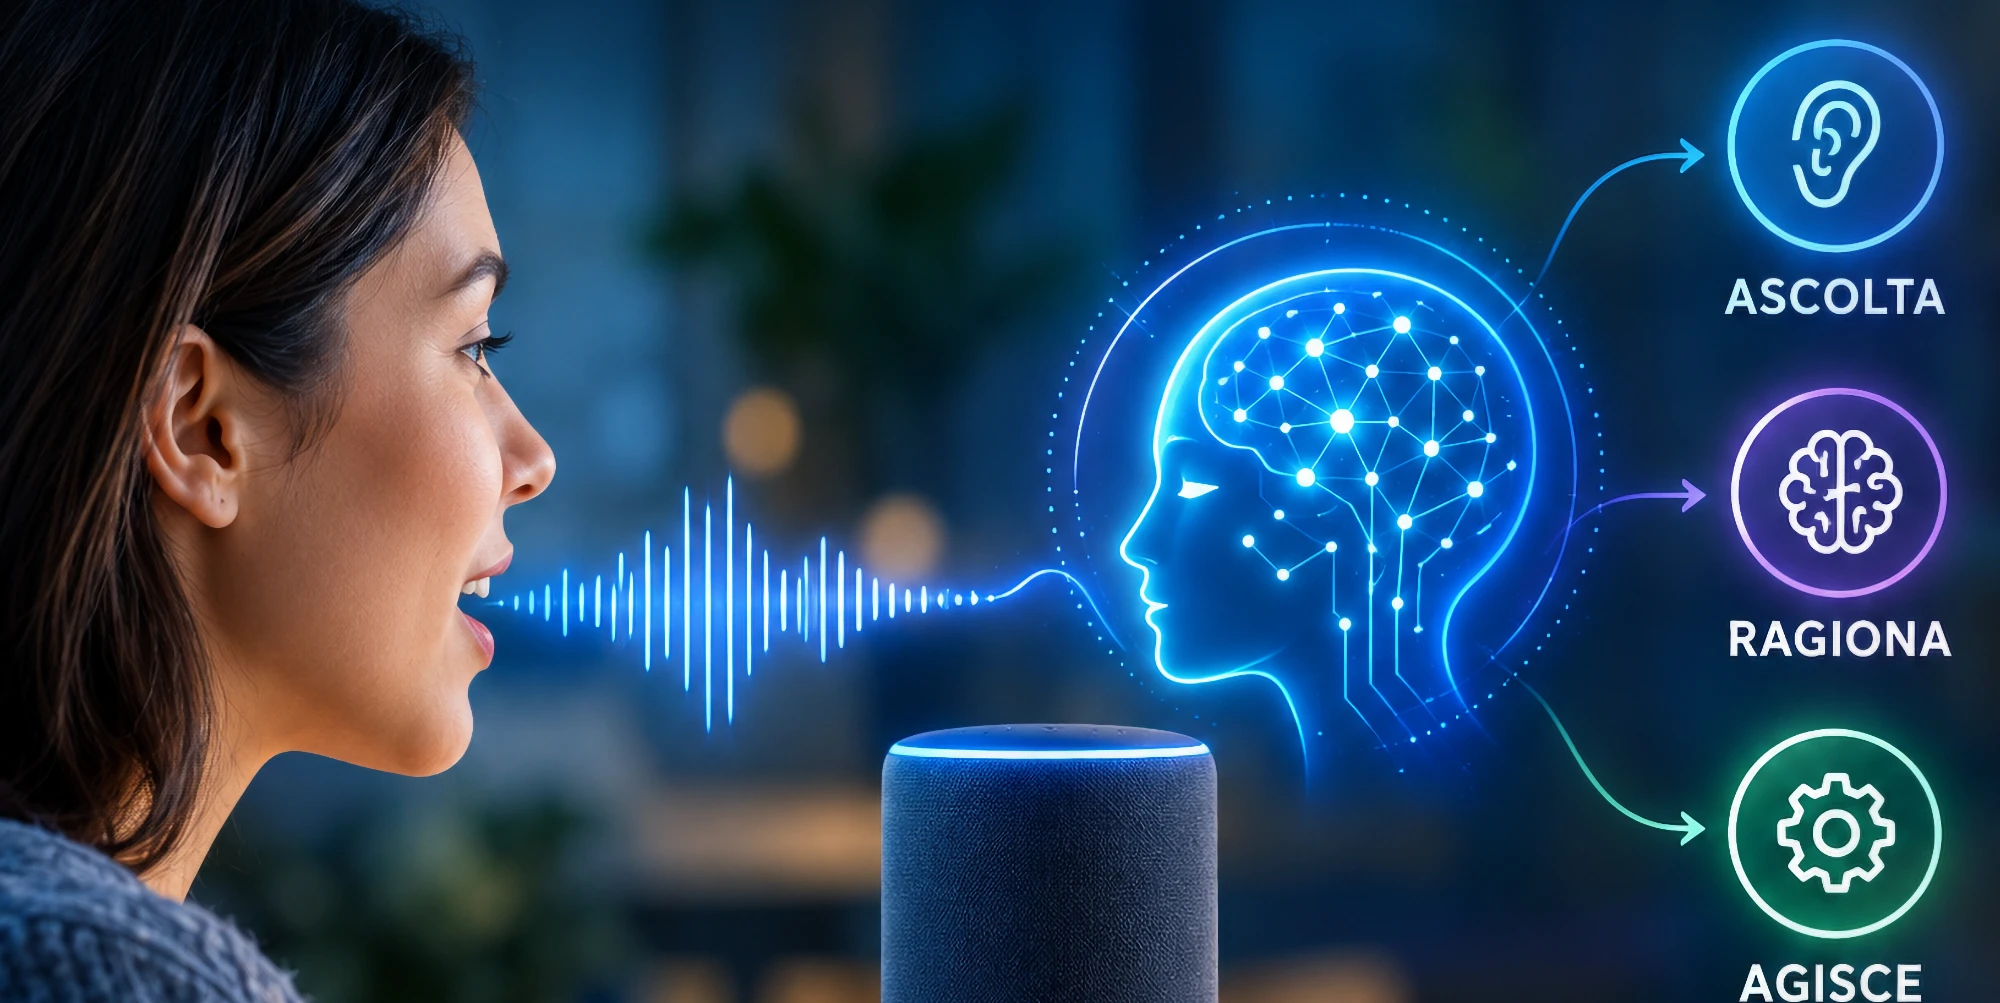
La vera innovazione non riguarda soltanto la qualità della voce. Il salto tecnologico arriva quando l’assistente può agire.
Un agente vocale potrebbe:
- controllare il calendario;
- cercare informazioni in un database;
- aggiornare un CRM;
- aprire un ticket di assistenza;
- verificare lo stato di un ordine;
- prenotare un appuntamento;
- analizzare un’immagine o una schermata;
- trasferire la conversazione a un operatore umano.
In questo scenario, la voce diventa l’interfaccia attraverso cui l’utente controlla un sistema più ampio.
Immaginiamo un servizio clienti per un’azienda tecnologica. Il cliente descrive un problema al router e mostra il dispositivo tramite la fotocamera. L’agente identifica il modello, legge le spie luminose, consulta la documentazione, verifica lo stato della linea e propone una soluzione. Se è necessario un intervento tecnico, può proporre alcuni orari e fissare l’appuntamento dopo aver ricevuto la conferma.
Perché la latenza è così importante
In una conversazione naturale, anche piccoli ritardi possono risultare fastidiosi. Se l’assistente impiega diversi secondi per rispondere dopo ogni frase, l’interazione appare artificiale.
Per questo i nuovi modelli lavorano su più aspetti contemporaneamente:
- riduzione del tempo necessario per iniziare la risposta;
- gestione delle interruzioni;
- riconoscimento dei turni di parola;
- comprensione di pause e rumori;
- esecuzione asincrona delle chiamate agli strumenti;
- possibilità di parlare mentre un’attività viene completata.
Google mette a disposizione modelli audio Live tramite Gemini API e Google AI Studio. OpenAI presenta GPT-Live-1 come modello API per applicazioni vocali full-duplex.
I limiti da non sottovalutare
Un assistente capace di agire può essere molto più utile di un chatbot, ma anche più rischioso. Un errore di interpretazione non produce soltanto una risposta sbagliata: potrebbe generare un’azione concreta.
Per questo le applicazioni vocali dovrebbero prevedere:
- conferma esplicita prima di azioni irreversibili;
- autorizzazioni limitate;
- registri delle operazioni eseguite;
- possibilità di annullare un’azione;
- trasferimento a un operatore umano;
- protezione dei dati audio e video;
- segnalazione chiara dei casi di incertezza.
È inoltre importante non confondere una voce naturale con una risposta affidabile. Un assistente può sembrare sicuro e convincente anche quando la sua interpretazione è incompleta.
Cosa ci aspetta
La direzione dello sviluppo è evidente: gli assistenti vocali stanno diventando interfacce multimodali e agentiche. Non saranno più strumenti utilizzati soltanto per fare domande, impostare promemoria o avviare una ricerca.
Potranno osservare il contesto, dialogare, pianificare e interagire con software e servizi esterni. La qualità di questi sistemi dipenderà quindi non solo dal modello, ma anche dalla progettazione dell’esperienza, dalla sicurezza e dai limiti assegnati all’agente.
La vera svolta della voce non è semplicemente parlare con una macchina. È poter collaborare con un sistema che ascolta, comprende il contesto e svolge attività mentre la conversazione continua.