Nuovi modelli multimodali, strumenti per l’inferenza locale e sistemi AI sempre più orientati all’esecuzione di attività complesse.
L’intelligenza artificiale sta attraversando una fase di trasformazione che va ben oltre il semplice aumento delle dimensioni dei modelli.
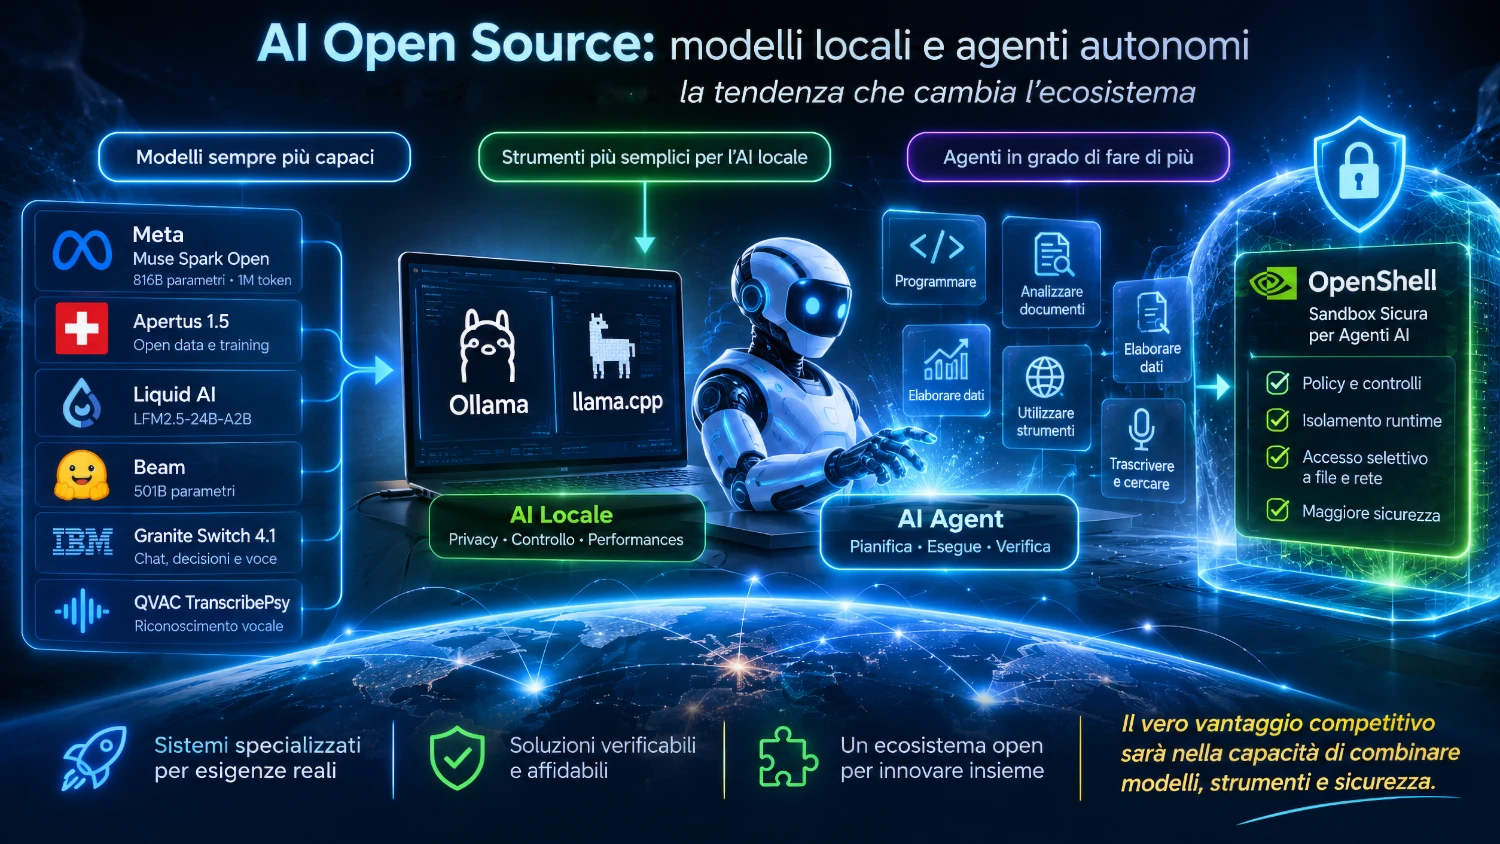
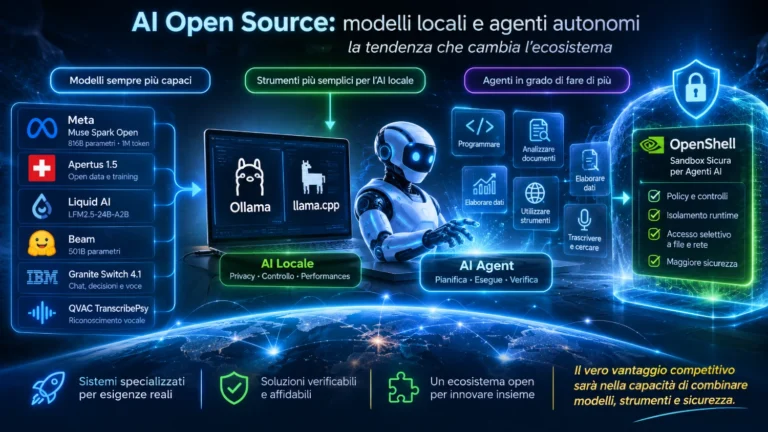
Diversi progetti hanno mostrato come l’ecosistema AI si stia evolvendo contemporaneamente su tre fronti: modelli più capaci, strumenti più accessibili per eseguirli sulle proprie infrastrutture e agenti in grado di utilizzare strumenti, prendere decisioni operative e portare a termine attività articolate.
Tra le novità più interessanti troviamo Muse Spark Open di Meta, Apertus 1.5, i nuovi modelli di Liquid AI, Beam e gli aggiornamenti dell’ecosistema Hugging Face.
Il punto centrale, però, non è stabilire quale modello abbia il maggior numero di parametri o ottenga il punteggio più alto in un benchmark.
La vera opportunità consiste nel combinare queste tecnologie per realizzare sistemi specializzati, verificabili e concretamente utili.
Vediamo cosa sta succedendo e quali conseguenze potrebbe avere per sviluppatori, ricercatori e appassionati di AI open source.
1. Muse Spark Open: modelli sempre più capaci e multimodali
Una delle novità più rilevanti della settimana è Muse Spark Open, presentato da Meta il 15 ottobre.
Il modello utilizza un’architettura Mixture of Experts (MoE) con 816 miliardi di parametri complessivi, dei quali circa 42 miliardi attivi per token. Supporta inoltre una finestra di contesto dichiarata di un milione di token ed è progettato per lavorare con testo, immagini, video e audio in ingresso.
Meta lo propone per attività come programmazione, ragionamento articolato e flussi di lavoro agentici.
La caratteristica più interessante è proprio la combinazione tra dimensioni, multimodalità e capacità operative.
Un modello di questo tipo non è pensato soltanto per rispondere a una domanda: può essere impiegato all’interno di sistemi che devono analizzare documenti, interpretare immagini, lavorare sul codice e utilizzare strumenti durante una sequenza di operazioni.
Anche l’infrastruttura software si sta adattando rapidamente. Il team di vLLM ha annunciato il supporto per Muse Spark Open già in concomitanza con il lancio, con funzionalità per l’esecuzione distribuita e l’utilizzo di strumenti.
Ma un modello più grande è sempre migliore?
Non necessariamente.
Le dimensioni di Muse Spark Open comportano requisiti hardware importanti. La possibilità di eseguire il modello su infrastrutture Apple Silicon, dimostrata utilizzando due Mac Studio con chip M5 Ultra, è interessante, ma non significa che sia facilmente utilizzabile su un normale PC.
Inoltre, è importante distinguere tra open-weight e open source: la disponibilità dei pesi non implica automaticamente che dati e processo di addestramento siano completamente aperti.
Per gli sviluppatori, Muse Spark Open rappresenta soprattutto un esempio di quanto stiano avanzando i modelli multimodali orientati alle attività complesse.
2. Apertus 1.5: la trasparenza diventa una caratteristica tecnica
Un’altra novità importante arriva dal progetto svizzero Apertus, che il 15 ottobre ha pubblicato le note tecniche della versione 1.5.
La famiglia comprende modelli da 8 e 70 miliardi di parametri e introduce funzionalità che estendono le capacità dei modelli precedenti.
Tra gli elementi più interessanti troviamo:
- comprensione delle immagini e funzionalità audio sperimentali;
- contesto fino a 262.144 token;
- ragionamento opzionale;
- miglioramenti nell’utilizzo degli strumenti;
- documentazione delle procedure di addestramento;
- disponibilità di checkpoint intermedi e miscele di dati utilizzate nelle diverse fasi.
Quest’ultimo punto merita particolare attenzione.
Molti modelli vengono presentati attraverso benchmark e dimostrazioni, ma spesso è difficile ricostruire il percorso che ha portato al risultato finale.
Apertus 1.5 punta invece a rendere più verificabile il processo, pubblicando materiali che consentono di studiare le diverse fasi dell’addestramento e valutare come cambiano le capacità del modello.
Per chi lavora sulla specializzazione dei modelli, questo approccio è particolarmente interessante.
Immaginiamo, per esempio, di voler realizzare un assistente dedicato alla documentazione tecnica, alla ricerca scientifica o all’analisi di documenti giuridici.
Avere accesso non soltanto ai pesi, ma anche a informazioni sul training e a checkpoint intermedi, può facilitare la ricerca e rendere più comprensibili le scelte tecniche.
L’apertura, in questo caso, non riguarda soltanto la possibilità di scaricare un modello: riguarda anche la possibilità di studiarne la costruzione.
3. Liquid AI LFM2.5-24B-A2B: meno parametri attivi, più attenzione all’efficienza
Il 13 ottobre Liquid AI ha presentato LFM2.5-24B-A2B, un modello Mixture of Experts che punta sull’efficienza durante l’inferenza.
Il modello ha 24 miliardi di parametri complessivi, ma ne attiva circa 2 miliardi per token. La presentazione mette in evidenza soprattutto le capacità di utilizzo degli strumenti e l’esecuzione locale.
Perché questa architettura è interessante?
Nei modelli tradizionali, il numero totale di parametri offre una prima indicazione delle dimensioni del sistema, ma non racconta tutta la storia.
Con un’architettura MoE, soltanto una parte degli esperti viene attivata per elaborare ciascun token.
Questo può ridurre il costo computazionale per token rispetto a un modello denso di dimensioni comparabili, anche se memoria necessaria, velocità effettiva e requisiti hardware dipendono dall’implementazione.
Liquid AI punta quindi su un compromesso differente rispetto ai modelli giganteschi: ottenere capacità utili mantenendo più contenuto il numero di parametri attivi.
La distinzione diventa particolarmente importante quando si sviluppano agenti.
Un agente può dover effettuare numerose chiamate al modello per completare una singola attività. Se ogni operazione è costosa o lenta, l’intero flusso di lavoro ne risente.
Un modello efficiente può quindi risultare più interessante di uno più grande in applicazioni che richiedono molte interazioni consecutive.
Naturalmente, le prestazioni vanno verificate sul proprio carico di lavoro: un risultato favorevole nei benchmark di tool use non implica automaticamente risultati migliori nella programmazione o nel ragionamento generale.
4. Beam: cresce l’offerta di modelli aperti di grandi dimensioni
Il 16 ottobre Hugging Face ha pubblicato la presentazione di Beam, un modello da 501 miliardi di parametri descritto come un modello aperto, personalizzabile e distribuibile dagli sviluppatori.
Il suo arrivo è indicativo di un’altra tendenza: l’ecosistema non si limita a proporre modelli piccoli per l’esecuzione locale, ma continua a sviluppare modelli di grandi dimensioni destinati a infrastrutture più potenti.
Occorre però distinguere due scenari.
Da una parte ci sono modelli progettati per essere eseguiti su un singolo computer, magari attraverso quantizzazione e ottimizzazioni specifiche.
Dall’altra ci sono modelli che richiedono memoria e capacità di calcolo distribuite su più dispositivi.
Per valutare Beam in un progetto reale, è quindi opportuno verificare direttamente la model card, la licenza, l’architettura, i requisiti hardware e la compatibilità con i runtime disponibili.
Il numero di parametri, da solo, non basta per stabilire se un modello sia conveniente o adatto a una determinata applicazione.
5. Granite Switch 4.1: un unico punto di accesso per chat, decisioni e voce
Il 15 ottobre è stata pubblicata su Hugging Face la presentazione di Granite Switch 4.1, una proposta di IBM che punta a riunire funzionalità conversazionali, decisionali e vocali attraverso un’unica interfaccia.
Questa direzione è interessante perché i sistemi AI stanno diventando sempre più compositi.
Un’applicazione non deve necessariamente affidare ogni operazione a un unico modello generalista.
Può utilizzare componenti differenti per comprendere una richiesta, interpretare il contesto, selezionare uno strumento ed eseguire un’azione.
L’obiettivo è costruire un sistema nel quale ciascun componente svolge un ruolo preciso, riducendo la complessità complessiva e facilitando la valutazione dei risultati.
Prima di scegliere una soluzione di questo tipo, è comunque importante controllare le capacità effettivamente disponibili, le lingue supportate e le modalità di distribuzione.
Il principio architetturale rimane valido: un sistema ben progettato può essere più utile di un singolo modello chiamato a fare tutto.
6. QVAC TranscribePsy: anche la voce entra nei flussi di lavoro locali
Tra le pubblicazioni recenti dell’ecosistema Hugging Face compare QVAC TranscribePsy, presentato come un sistema di riconoscimento vocale multilingue orientato all’esecuzione sul dispositivo.
La trascrizione vocale può sembrare un’attività separata dall’evoluzione degli LLM, ma in realtà costituisce una componente importante di molti sistemi AI.
Pensiamo a un’applicazione che deve elaborare registrazioni, riunioni, interviste o documenti audio.
Il flusso potrebbe essere organizzato in questo modo:
- Il sistema riceve una registrazione.
- Il modello vocale converte il parlato in testo.
- Il testo viene suddiviso in segmenti.
- Un sistema di embedding rappresenta semanticamente i contenuti.
- Un database vettoriale indicizza le informazioni.
- Un LLM risponde alle domande utilizzando i passaggi recuperati.
Il risultato è un sistema RAG che permette di interrogare un archivio audio attraverso il linguaggio naturale.
La possibilità di eseguire localmente alcune di queste operazioni può inoltre ridurre la necessità di trasferire registrazioni a servizi esterni.
Prima di utilizzare il modello in produzione, rimane essenziale verificare la qualità della trascrizione nella lingua desiderata, la licenza e i requisiti di esecuzione.
7. Transformers: l’infrastruttura software è importante quanto i modelli
Un altro elemento da osservare è l’evoluzione delle librerie che consentono di utilizzare i modelli.
L’ecosistema Hugging Face continua a pubblicare aggiornamenti e integrazioni per nuove architetture. Le novità della settimana comprendono anche FLUX.3 Image Klein in Diffusers e altre integrazioni legate ai modelli recenti.
Questo aspetto è meno appariscente del lancio di un nuovo LLM, ma è fondamentale.
Un modello può essere tecnicamente disponibile e tuttavia risultare difficile da utilizzare se mancano implementazioni, kernel ottimizzati, supporto per la quantizzazione o integrazioni con i runtime più diffusi.
Quando un nuovo modello viene integrato negli strumenti già utilizzati dagli sviluppatori, il costo necessario per sperimentarlo diminuisce.
È proprio questa combinazione tra modelli e infrastruttura software a rendere l’ecosistema open source così dinamico.
8. La vera evoluzione: dagli LLM agli agenti capaci di lavorare
Finora abbiamo parlato di modelli, architetture e strumenti di esecuzione.
Ma la trasformazione più importante riguarda ciò che possiamo costruire combinandoli.
Un LLM tradizionale riceve un input e genera una risposta.
Un agente, invece, può utilizzare il modello per pianificare una sequenza di operazioni, richiamare strumenti, valutare i risultati e correggere il proprio comportamento quando qualcosa non funziona.
Per esempio, un agente di programmazione potrebbe:
- analizzare un repository;
- individuare un problema;
- modificare il codice;
- eseguire i test;
- interpretare gli errori;
- applicare ulteriori correzioni;
- produrre un riepilogo delle modifiche.
Il modello rimane il componente che interpreta il problema e contribuisce a scegliere le azioni, ma il risultato dipende anche dagli strumenti disponibili, dal runtime, dal contesto e dai controlli applicati.
Questa distinzione è fondamentale.
Un modello molto capace non garantisce automaticamente un agente affidabile.
Per costruire un sistema utile servono anche gestione dello stato, accesso agli strumenti, verifica dei risultati e meccanismi per impedire operazioni non autorizzate.
Il ruolo della sicurezza: il caso NVIDIA OpenShell
In questo scenario si inseriscono progetti come NVIDIA OpenShell, che affrontano il problema dell’isolamento e del controllo delle attività degli agenti.
L’idea è eseguire l’agente in un ambiente nel quale l’accesso a file, processi, rete e altri strumenti sia regolato da policy.
In questo modo si cerca di separare due domande:
- Che cosa dovrebbe fare l’agente?
- Che cosa è effettivamente autorizzato a fare?
La seconda domanda non può essere affidata esclusivamente alle istruzioni del prompt.
Un sistema progettato correttamente deve imporre i limiti anche a livello dell’infrastruttura.
Questo diventa particolarmente importante quando gli agenti possono eseguire codice, accedere a repository o interagire con servizi esterni.
La direzione è chiara: quanto più aumenta l’autonomia, tanto più diventano importanti isolamento, tracciabilità e verifica delle azioni.
9. Perché combinare questi elementi può essere più utile che cercare il modello perfetto
Immaginiamo di voler costruire un assistente AI specializzato nell’analisi di documentazione tecnica.
Potremmo organizzare il sistema in questo modo:
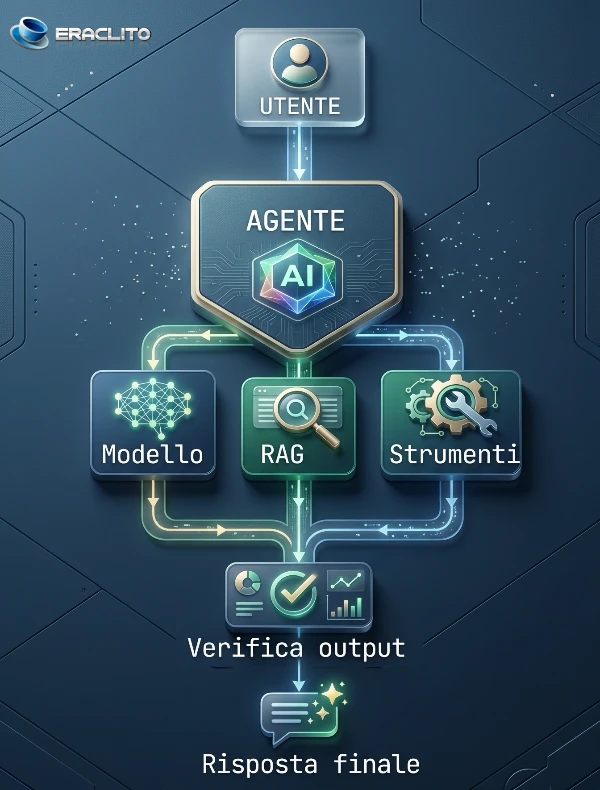
Il modello interpreta la richiesta.
Il sistema RAG recupera i documenti pertinenti.
Gli strumenti consentono di eseguire operazioni concrete.
La fase di verifica controlla, per quanto possibile, che il risultato sia coerente con le fonti o con i requisiti stabiliti.
Se l’agente deve anche modificare file o eseguire comandi, un ambiente isolato può limitare i danni derivanti da errori o operazioni indesiderate.
Il risultato può essere molto più utile di una chat generica, anche senza utilizzare il modello più grande disponibile.
La qualità finale dipende dalla progettazione dell’intero sistema.
10. Il futuro dell’AI locale: non soltanto modelli più piccoli
L’AI locale viene spesso associata a modelli ridotti, eseguiti su un computer personale.
Questa visione è però incompleta.
L’esecuzione locale riguarda anche la possibilità di controllare l’infrastruttura, gestire i dati e scegliere quali componenti debbano funzionare senza servizi esterni.
Un’architettura locale può combinare:
- un modello linguistico;
- un sistema RAG;
- modelli per immagini o audio;
- un runtime di inferenza;
- strumenti per gli agenti;
- un database;
- un ambiente isolato per l’esecuzione delle operazioni.
Non è necessario che tutti i componenti siano ospitati nello stesso processo o che utilizzino lo stesso modello.
Anzi, la separazione tra componenti può migliorare la manutenibilità e rendere più semplice sostituire un elemento senza riprogettare l’intero sistema.
La scelta dipende dai requisiti: privacy, latenza, costo, qualità delle risposte, disponibilità hardware e complessità operativa.
11. Le opportunità concrete per gli sviluppatori
Le novità di questa settimana suggeriscono alcune direzioni di lavoro particolarmente interessanti.
AI specializzata
Invece di costruire un assistente generico, si può partire da un modello adatto e collegarlo a un insieme di dati e strumenti dedicati a un settore.
Esempi: documentazione tecnica, ricerca scientifica, assistenza interna, analisi documentale e supporto alla programmazione.
RAG verificabile
Il retrieval-augmented generation permette di collegare un modello a documenti selezionati, riducendo la dipendenza dalle sole informazioni apprese durante l’addestramento.
Il passo successivo è verificare che le risposte siano sostenute dalle fonti recuperate e rendere chiaro quando le informazioni disponibili non sono sufficienti.
Agenti con strumenti
Gli agenti possono utilizzare API, database, repository e applicazioni per completare attività articolate.
Il valore non deriva soltanto dalla capacità di pianificare, ma anche dall’affidabilità con cui eseguono ogni passaggio.
Sistemi multimodali
La combinazione di modelli per testo, immagini e audio permette di creare applicazioni che elaborano informazioni provenienti da fonti diverse.
È una direzione promettente per archivi documentali, assistenti vocali, analisi di immagini e ricerca su registrazioni.
Sicurezza e osservabilità
Quando un agente può compiere azioni reali, diventa importante registrare ciò che fa, controllare gli accessi e verificare i risultati.
Isolamento, policy e strumenti di monitoraggio dovrebbero essere considerati parte dell’architettura fin dall’inizio.
Conclusioni: il vantaggio competitivo sarà nell’architettura
Le novità della settimana mostrano un ecosistema AI sempre più diversificato.
Muse Spark Open spinge verso modelli multimodali e capacità agentiche più avanzate. Apertus 1.5 mette in evidenza l’importanza della trasparenza e della riproducibilità. Liquid AI propone un approccio orientato all’efficienza, mentre Beam amplia l’offerta di modelli di grandi dimensioni. I progetti per la voce e gli aggiornamenti dell’infrastruttura software completano un panorama in continua evoluzione.
Queste iniziative non risolvono tutte lo stesso problema e non sono necessariamente alternative dirette.
La loro importanza sta nel fatto che ampliano le possibilità a disposizione degli sviluppatori.
Il vero salto, però, avviene quando queste tecnologie vengono combinate in un sistema progettato intorno a un obiettivo preciso.
Un modello non deve necessariamente sapere fare tutto. Può essere specializzato, collegato a fonti affidabili, dotato di strumenti e inserito in un ambiente che ne controlla le azioni.
La vera opportunità dell’AI open source non è soltanto accedere a modelli sempre più potenti, ma costruire sistemi specializzati, verificabili e realmente utili.
È qui che si giocherà una parte importante della prossima fase dell’intelligenza artificiale: non soltanto nella qualità dei modelli, ma nella capacità di trasformarli in strumenti affidabili per risolvere problemi concreti.